Learning at Proteome Scale!


The wonderful folks in the Steinegger group have developed FoldComp, an excellent tool for managing and compressing databases of predicted structures.
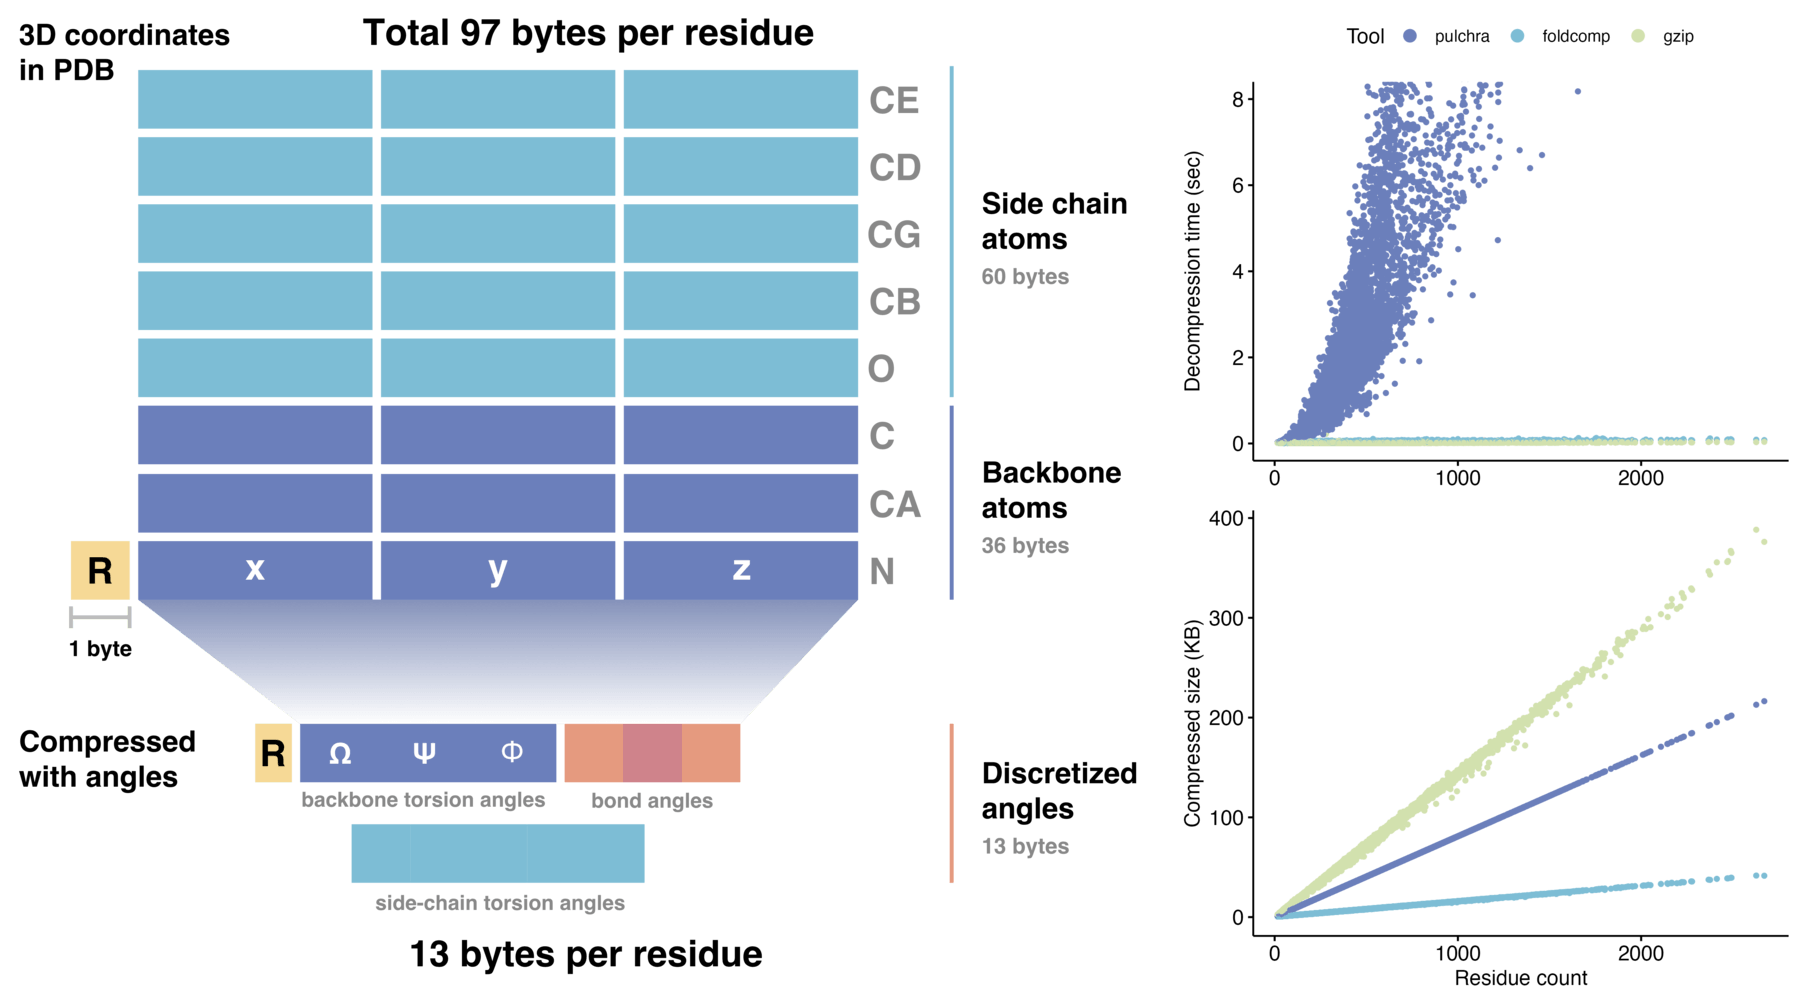
We can use this as a helpful backend for managing massive protein structure datasets with an order-of-magnitude disk space saving.
The FoldCompDataset class in Graphein enables parsing to both PyG Data and Graphein Protein/ProteinBatch objects (see this tutorial for more).
[27]:
from graphein.ml.datasets.foldcomp_dataset import FoldCompDataset
from rich import inspect

inspect(FoldCompDataset)
╭──────────────────────── <class 'graphein.ml.datasets.foldcomp_dataset.FoldCompDataset'> ────────────────────────╮
│ class FoldCompDataset(root: str, database: str, ids: Optional[List[str]] = None, exclude_ids:                   │
│ Optional[List[str]] = None, fraction: float = 1.0, use_graphein: bool = True, transform:                        │
│ Optional[List[Callable[[Union[torch_geometric.data.data.Data, graphein.protein.tensor.data.Protein]],           │
│ Union[torch_geometric.data.data.Data, graphein.protein.tensor.data.Protein]]]] = None):                         │
│                                                                                                                 │
│ Dataset base class for creating graph datasets.                                                                 │
│ See `here <https://pytorch-geometric.readthedocs.io/en/latest/notes/                                            │
│ create_dataset.html>`__ for the accompanying tutorial.                                                          │
│                                                                                                                 │
│          num_classes = <property object at 0x7f50c990f7c0>                                                      │
│    num_edge_features = <property object at 0x7f50c990f770>                                                      │
│         num_features = <property object at 0x7f50c990f720>                                                      │
│    num_node_features = <property object at 0x7f50c990f6d0>                                                      │
│        processed_dir = <property object at 0x7f50c990f680>                                                      │
│ processed_file_names = <property object at 0x7f50c50ca3b0>                                                      │
│      processed_paths = <property object at 0x7f50c990f860>                                                      │
│              raw_dir = <property object at 0x7f50cea66ef0>                                                      │
│       raw_file_names = <property object at 0x7f50c50ca360>                                                      │
│            raw_paths = <property object at 0x7f50c990f810>                                                      │
╰─────────────────────────────────────────────────────────────────────────────────────────────────────────────────╯
[26]:
ds = FoldCompDataset(
    root="./test_data/", # Set directory path to download data to
    database="afdb_swissprot_v4", # Name of the database. See: https://github.com/steineggerlab/foldcomp
    ids=None, # List of IDs to include in the dataset. If None, all IDs are included.
    fraction=1, # Fraction of database to use
    use_graphein=True # Whether or not to use Graphein's Protein objects or to use standard PyG Data
)

print("Number of proteins in dataset: ", len(ds))
100%|██████████| 542378/542378 [00:00<00:00, 3310570.45it/s]
[03/24/23 00:08:12] INFO Sampling fraction: 1... foldcomp_dataset.py:127
[03/24/23 00:08:13] INFO Creating index... foldcomp_dataset.py:132
INFO Dataset contains 542378 chains. foldcomp_dataset.py:136
Processing...
INFO Opening database... foldcomp_dataset.py:141
Number of proteins in dataset: 542378
Done!
Protein(fill_value=1e-05, atom_list=[37], id='AF-P42477-F1-model_v4.pdb', x=[400, 37, 3], residues=[400], chains=[400], residue_id=[400], residue_type=[400])
Protein(fill_value=1e-05, atom_list=[37], id='AF-Q758U2-F1-model_v4.pdb', x=[383, 37, 3], residues=[383], chains=[383], residue_id=[383], residue_type=[383])
Protein(fill_value=1e-05, atom_list=[37], id='AF-B2TY17-F1-model_v4.pdb', x=[97, 37, 3], residues=[97], chains=[97], residue_id=[97], residue_type=[97])
Protein(fill_value=1e-05, atom_list=[37], id='AF-B7XIW9-F1-model_v4.pdb', x=[224, 37, 3], residues=[224], chains=[224], residue_id=[224], residue_type=[224])
Protein(fill_value=1e-05, atom_list=[37], id='AF-Q2NYM2-F1-model_v4.pdb', x=[297, 37, 3], residues=[297], chains=[297], residue_id=[297], residue_type=[297])
Protein(fill_value=1e-05, atom_list=[37], id='AF-P36990-F1-model_v4.pdb', x=[49, 37, 3], residues=[49], chains=[49], residue_id=[49], residue_type=[49])
Protein(fill_value=1e-05, atom_list=[37], id='AF-P15431-F1-model_v4.pdb', x=[474, 37, 3], residues=[474], chains=[474], residue_id=[474], residue_type=[474])
Protein(fill_value=1e-05, atom_list=[37], id='AF-A5IS81-F1-model_v4.pdb', x=[163, 37, 3], residues=[163], chains=[163], residue_id=[163], residue_type=[163])
Protein(fill_value=1e-05, atom_list=[37], id='AF-P16643-F1-model_v4.pdb', x=[103, 37, 3], residues=[103], chains=[103], residue_id=[103], residue_type=[103])
Protein(fill_value=1e-05, atom_list=[37], id='AF-Q21M35-F1-model_v4.pdb', x=[131, 37, 3], residues=[131], chains=[131], residue_id=[131], residue_type=[131])
Protein(fill_value=1e-05, atom_list=[37], id='AF-B7LMI2-F1-model_v4.pdb', x=[356, 37, 3], residues=[356], chains=[356], residue_id=[356], residue_type=[356])
Selection
You can access proteins in two ways:
Using their index
By their ID
Protein(fill_value=1e-05, atom_list=[37], id='AF-B7LMI2-F1-model_v4.pdb', x=[356, 37, 3], residues=[356], chains=[356], residue_id=[356], residue_type=[356])
Data type cannot be displayed: application/vnd.plotly.v1+json
Protein(fill_value=1e-05, atom_list=[37], id='AF-B7LMI2-F1-model_v4.pdb', x=[356, 37, 3], residues=[356], chains=[356], residue_id=[356], residue_type=[356])
Data type cannot be displayed: application/vnd.plotly.v1+json
Creating a Dataloader
[19]:
from torch_geometric.loader import DataLoader

dl = DataLoader(ds, batch_size=32, shuffle=True)

for i, batch in enumerate(dl):
    print(batch)
    if i == 5: break
ProteinBatch(fill_value=[32], atom_list=[32], id=[32], x=[13272, 37, 3], residues=[32], chains=[13272], residue_id=[32], residue_type=[13272], batch=[13272], ptr=[33])
ProteinBatch(fill_value=[32], atom_list=[32], id=[32], x=[11045, 37, 3], residues=[32], chains=[11045], residue_id=[32], residue_type=[11045], batch=[11045], ptr=[33])
ProteinBatch(fill_value=[32], atom_list=[32], id=[32], x=[10277, 37, 3], residues=[32], chains=[10277], residue_id=[32], residue_type=[10277], batch=[10277], ptr=[33])
ProteinBatch(fill_value=[32], atom_list=[32], id=[32], x=[11266, 37, 3], residues=[32], chains=[11266], residue_id=[32], residue_type=[11266], batch=[11266], ptr=[33])
ProteinBatch(fill_value=[32], atom_list=[32], id=[32], x=[10598, 37, 3], residues=[32], chains=[10598], residue_id=[32], residue_type=[10598], batch=[10598], ptr=[33])
ProteinBatch(fill_value=[32], atom_list=[32], id=[32], x=[10498, 37, 3], residues=[32], chains=[10498], residue_id=[32], residue_type=[10498], batch=[10498], ptr=[33])
[20]:
batch.plot_structure()
Data type cannot be displayed: application/vnd.plotly.v1+json
Pure PyG
If we set use_graphein to False, we get standard PyG data objects.
[32]:
ds = FoldCompDataset(
    root="./test_data/",
    database="afdb_swissprot_v4",
    ids=None,
    fraction=1,
    use_graphein=False
)
100%|██████████| 542378/542378 [00:00<00:00, 3182352.35it/s]
[03/24/23 00:09:33] INFO Sampling fraction: 1... foldcomp_dataset.py:127
INFO Creating index... foldcomp_dataset.py:132
INFO Dataset contains 542378 chains. foldcomp_dataset.py:136
Processing...
INFO Opening database... foldcomp_dataset.py:141
Done!
Data(residue_type=[1218], x=[1218, 37, 3], residues=[1218], residue_id=[1218], id='AF-Q54WH2-F1-model_v4.pdb', fill_value=1e-05, atom_list=[37], chains=[1218])
<class 'torch_geometric.data.data.Data'>
Plug and play with Pytorch Lightning!
We provide a PyTorch Lightning `LightningDataModule <https://lightning.ai/docs/pytorch/latest/data/datamodule.html>`__ wrapper for FoldComp datasets.
[21]:
from graphein.ml.datasets.foldcomp_dataset import FoldCompLightningDataModule
from rich import inspect

inspect(FoldCompLightningDataModule)
╭────────────────── <class 'graphein.ml.datasets.foldcomp_dataset.FoldCompLightningDataModule'> ──────────────────╮
│ class FoldCompLightningDataModule(data_dir, database: str, batch_size: int, use_graphein: bool = True,          │
│ train_split: Union[List[str], float, NoneType] = None, val_split: Union[List[str], float, NoneType] = None,     │
│ test_split: Union[List[str], float, NoneType] = None, transform:                                                │
│ Optional[List[Callable[[Union[torch_geometric.data.data.Data, graphein.protein.tensor.data.Protein]],           │
│ Union[torch_geometric.data.data.Data, graphein.protein.tensor.data.Protein]]]] = None, num_workers: int = 4,    │
│ pin_memory: bool = True) -> None:                                                                               │
│                                                                                                                 │
│ A DataModule standardizes the training, val, test splits, data preparation and transforms. The main             │
│ advantage is consistent data splits, data preparation and transforms across models.                             │
│                                                                                                                 │
│  CHECKPOINT_HYPER_PARAMS_KEY = 'datamodule_hyper_parameters'                                                    │
│ CHECKPOINT_HYPER_PARAMS_NAME = 'datamodule_hparams_name'                                                        │
│ CHECKPOINT_HYPER_PARAMS_TYPE = 'datamodule_hparams_type'                                                        │
│                      hparams = <property object at 0x7f50c52da860>                                              │
│              hparams_initial = <property object at 0x7f50c52da8b0>                                              │
│                         name = None                                                                             │
╰─────────────────────────────────────────────────────────────────────────────────────────────────────────────────╯
[22]:
data_module = FoldCompLightningDataModule(
    data_dir="./test_data/",
    database="afdb_swissprot_v4",
    batch_size=32,
    num_workers=4
    )

data_module.setup()
[03/25/23 02:09:30] INFO Creating training dataset... foldcomp_dataset.py:366
100%|██████████| 542378/542378 [00:00<00:00, 3294375.73it/s]
INFO Sampling fraction: 1.0... foldcomp_dataset.py:190
INFO Creating index... foldcomp_dataset.py:195
INFO Dataset contains 542378 chains. foldcomp_dataset.py:199
Processing...
INFO Opening database... foldcomp_dataset.py:204
Done!
[03/25/23 02:09:31] INFO Creating validation dataset... foldcomp_dataset.py:371
100%|██████████| 542378/542378 [00:00<00:00, 3300761.77it/s]
INFO Sampling fraction: 1.0... foldcomp_dataset.py:190
INFO Creating index... foldcomp_dataset.py:195
INFO Dataset contains 542378 chains. foldcomp_dataset.py:199
Processing...
INFO Opening database... foldcomp_dataset.py:204
Done!
INFO Creating test dataset... foldcomp_dataset.py:376
100%|██████████| 542378/542378 [00:00<00:00, 3199872.58it/s]
[03/25/23 02:09:32] INFO Sampling fraction: 1.0... foldcomp_dataset.py:190
INFO Creating index... foldcomp_dataset.py:195
INFO Dataset contains 542378 chains. foldcomp_dataset.py:199
Processing...
INFO Opening database... foldcomp_dataset.py:204
Done!
[23]:
# Accessing dataset
print(data_module.train_ds)
print(data_module.val_ds)
print(data_module.test_ds)

print(data_module.train_dataloader())
print(data_module.val_dataloader())
print(data_module.test_dataloader())
FoldCompDataset(542378)
FoldCompDataset(542378)
FoldCompDataset(542378)
<torch_geometric.loader.dataloader.DataLoader object at 0x7f50bf730a90>
<torch_geometric.loader.dataloader.DataLoader object at 0x7f50bf730a30>
<torch_geometric.loader.dataloader.DataLoader object at 0x7f50bf730a90>
Splitting the data
You can create splits by providing floats specifying the size of each partition, or a list of identifiers
[24]:
# Splitting the data with partition sizes

data_module = FoldCompLightningDataModule(
    data_dir="./test_data/",
    database="afdb_swissprot_v4",
    batch_size=32,
    num_workers=4,
    train_split=0.7,
    val_split=0.2,
    test_split=0.1
    )

data_module.setup()
[03/25/23 02:09:38] INFO Getting indices (loading complete database)... foldcomp_dataset.py:321
100%|██████████| 542378/542378 [00:00<00:00, 3289516.77it/s]
INFO Sampling fraction: 1.0... foldcomp_dataset.py:190
INFO Creating index... foldcomp_dataset.py:195
[03/25/23 02:09:39] INFO Dataset contains 542378 chains. foldcomp_dataset.py:199
Processing...
INFO Opening database... foldcomp_dataset.py:204
Done!
                    INFO     Split data into train (0.7, 379664), val (0.2, 108476) and     foldcomp_dataset.py:307
                             test (0.1, 54238) sets.
INFO Creating training dataset... foldcomp_dataset.py:366
100%|██████████| 542378/542378 [00:00<00:00, 3292825.97it/s]
INFO Sampling fraction: 1.0... foldcomp_dataset.py:190
INFO Creating index... foldcomp_dataset.py:195
[03/25/23 02:09:40] INFO Dataset contains 379664 chains. foldcomp_dataset.py:199
Processing...
INFO Opening database... foldcomp_dataset.py:204
Done!
INFO Creating validation dataset... foldcomp_dataset.py:371
100%|██████████| 542378/542378 [00:00<00:00, 3297972.00it/s]
INFO Sampling fraction: 1.0... foldcomp_dataset.py:190
INFO Creating index... foldcomp_dataset.py:195
INFO Dataset contains 108476 chains. foldcomp_dataset.py:199
Processing...
INFO Opening database... foldcomp_dataset.py:204
Done!
INFO Creating test dataset... foldcomp_dataset.py:376
100%|██████████| 542378/542378 [00:00<00:00, 3280352.50it/s]
INFO Sampling fraction: 1.0... foldcomp_dataset.py:190
INFO Creating index... foldcomp_dataset.py:195
INFO Dataset contains 54238 chains. foldcomp_dataset.py:199
Processing...
INFO Opening database... foldcomp_dataset.py:204
Done!
[25]:
train_ids = ["AF-P64030-F1-model_v4", "AF-P64488-F1-model_v4"]
val_ids = ["AF-B2ICL0-F1-model_v4"]
test_ids = ["AF-P64488-F1-model_v4"]


data_module = FoldCompLightningDataModule(
    data_dir="./test_data/",
    database="afdb_swissprot_v4",
    batch_size=32,
    num_workers=4,
    train_split=train_ids,
    val_split=val_ids,
    test_split=test_ids
)
data_module.setup()
[03/25/23 02:09:43] INFO Creating training dataset... foldcomp_dataset.py:366
100%|██████████| 542378/542378 [00:00<00:00, 3306408.35it/s]
INFO Sampling fraction: 1.0... foldcomp_dataset.py:190
INFO Creating index... foldcomp_dataset.py:195
INFO Dataset contains 2 chains. foldcomp_dataset.py:199
Processing...
INFO Opening database... foldcomp_dataset.py:204
Done!
INFO Creating validation dataset... foldcomp_dataset.py:371
100%|██████████| 542378/542378 [00:00<00:00, 3289488.23it/s]
INFO Sampling fraction: 1.0... foldcomp_dataset.py:190
INFO Creating index... foldcomp_dataset.py:195
INFO Dataset contains 1 chains. foldcomp_dataset.py:199
Processing...
INFO Opening database... foldcomp_dataset.py:204
Done!
INFO Creating test dataset... foldcomp_dataset.py:376
100%|██████████| 542378/542378 [00:00<00:00, 3294728.80it/s]
[03/25/23 02:09:44] INFO Sampling fraction: 1.0... foldcomp_dataset.py:190
INFO Creating index... foldcomp_dataset.py:195
INFO Dataset contains 1 chains. foldcomp_dataset.py:199
Processing...
INFO Opening database... foldcomp_dataset.py:204
Done!
[26]:
FoldCompDataset(2)
Protein(fill_value=1e-05, atom_list=[37], id='AF-P64488-F1-model_v4.pdb', x=[119, 37, 3], residues=[119], chains=[119], residue_id=[119], residue_type=[119])
Protein(fill_value=1e-05, atom_list=[37], id='AF-P64030-F1-model_v4.pdb', x=[398, 37, 3], residues=[398], chains=[398], residue_id=[398], residue_type=[398])
FoldCompDataset()
Protein(fill_value=1e-05, atom_list=[37], id='AF-B2ICL0-F1-model_v4.pdb', x=[276, 37, 3], residues=[276], chains=[276], residue_id=[276], residue_type=[276])
FoldCompDataset()
Protein(fill_value=1e-05, atom_list=[37], id='AF-P64488-F1-model_v4.pdb', x=[119, 37, 3], residues=[119], chains=[119], residue_id=[119], residue_type=[119])